Data Lakehouse: Die Evolution der modernen Datenarchitektur
Ein Data Lakehouse verbindet die strukturierte Datenhaltung eines Data Warehouse mit der Flexibilität eines Data Lake. Unternehmen schaffen damit eine skalierbare Grundlage für Business Intelligence, Analytics und AI und können unterschiedliche Daten und Anwendungsfälle in einer gemeinsamen Architektur zusammenführen. QUNIS begleitet Sie von der Konzeption und Architektur über die Auswahl geeigneter Technologien bis zur Implementierung und Integration in Ihre Datenlandschaft.
Warum Unternehmen auf ein Data Lakehouse setzen
Lange Zeit mussten Unternehmen zwischen der strukturierten Performance eines Data Warehouse und der flexiblen Skalierbarkeit eines Data Lake wählen. Das Data Lakehouse vereint die Stärken beider Ansätze in einer gemeinsamen Architektur. Es ermöglicht die flexible Speicherung großer Mengen strukturierter, semi-strukturierter und unstrukturierter Daten bei gleichzeitig hoher Transaktionssicherheit und schnellen Abfragegeschwindigkeiten. So entsteht eine skalierbare Grundlage für unterschiedliche analytische Anforderungen – von Business Intelligence und Reporting über Analytics und Data Science bis zu IoT und AI.
Definition
Ein Data Lakehouse bezeichnet eine einheitliche Datenarchitektur, die die flexible Speicherung großer, auch unstrukturierter Datenmengen eines Data Lakes mit der strukturierten Datenhaltung und hohen Abfrageperformance eines Data Warehouses verbindet und damit verschiedene Analysefunktionen unterstützt. Abgesichert durch ACID-Transaktionen, Versionierung und Data Governance und offen gestaltet über Interoperabilität und modulare Architekturprinzipien (Open Lakehouse).
Welchen Nutzen bietet ein Data Lakehouse, gerade für mittelständische Unternehmen?
Ein zentraler Speicherort für alle Unternehmensdaten reduziert Datensilos und sorgt für eine konsistente Datenbasis mit weniger Redundanz. Cloud-Ressourcen und Pay-per-Use-Modelle senken die Kosten, da nicht mehrere getrennte Speichersysteme betrieben werden müssen und nur die tatsächlich genutzte Kapazität bezahlt wird. Gleichzeitig wächst die Architektur mit den Datenmengen mit, neue Datenquellen lassen sich einfach anbinden und Anwendungsszenarien wie Machine Learning oder Echtzeit-Auswertungen werden möglich. Ein offener Ansatz (Open Lakehouse) vermeidet zudem Abhängigkeiten von einzelnen Anbietern.
Vereint Data Lake und Data Warehouse auf einer zentralen Plattform.
Speichert strukturierte, semi-strukturierte und unstrukturierte Daten im Originalformat.
Weniger Datenredundanz und Datensilos durch eine konsistente Datenbasis.
Open Lakehouse vermeidet Abhängigkeiten durch Interoperabilität und modulare Bausteine.
Wie läuft eine Beratung für den Aufbau eines Data Lakehouse ab?
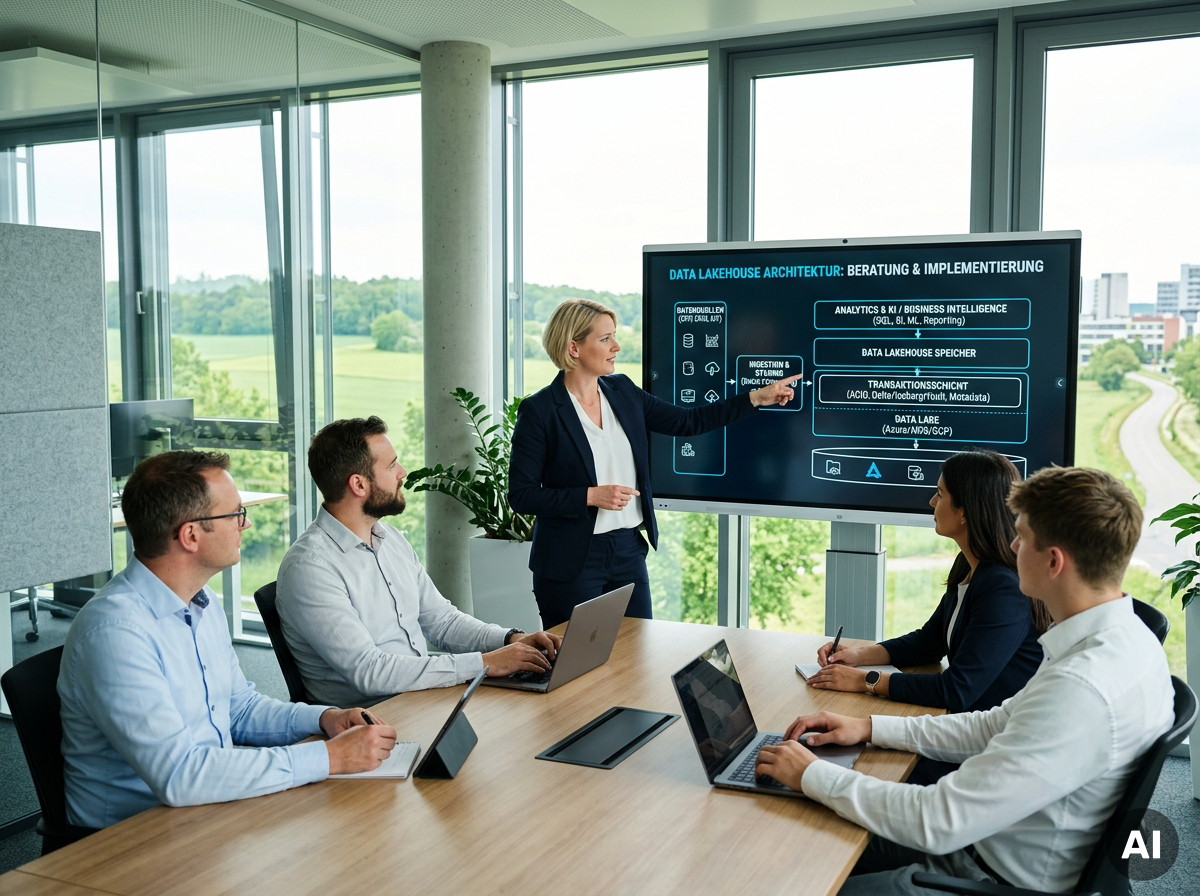
Eine spezialisierte Beratung begleitet Unternehmen schrittweise vom Konzept bis zum Betrieb. Am Anfang steht eine gemeinsame
Data Strategy mit Roadmap, in der Ziele, Anwendungsfälle, Datenkomponenten und organisatorische Voraussetzungen festgelegt werden. Danach wird das Gesamtprojekt in konkrete Use Cases aufgeteilt („Slice the Elephant“), die mit frühen Demos und MVPs für die Fachbereiche schrittweise umgesetzt werden. Die Datenarchitektur wächst agil mit den Anforderungen. Schulungen und Enablement bauen das nötige Know-how im Unternehmen auf, damit die Lösung später selbstständig weiterentwickelt werden kann.
Ein zentrales Fundament für Business Intelligence und AI
Durch die Konsolidierung der Speicherarchitektur entfallen aufwendige und fehleranfällige Kopierprozesse zwischen verschiedenen Systemen. Standardisierte Berichte aus dem Controlling sowie komplexe Analytics- und Data-Science-Anwendungen greifen auf dieselbe verlässliche Datenbasis zu. Diese technologische Harmonisierung beschleunigt die Bereitstellung neuer Erkenntnisse massiv. Fachbereiche profitieren von einer extrem schnellen Time-to-Insight, während die IT von einem stark reduzierten Verwaltungs- und Wartungsaufwand entlastet wird. Die Zusammenführung schafft maximale Synergien für traditionelle Analysen ebenso wie für moderne Machine-Learning-Modelle und AI-Anwendungen.
Technologische Unabhängigkeit und flexible Skalierung
Wir unterstützen Sie ganzheitlich bei der Konzeption und Implementierung Ihrer Data-Lakehouse-Architektur. Dabei agieren wir herstellerunabhängig und finden die Plattform, die zu Ihren Rahmenbedingungen passt, ob Microsoft Fabric, Databricks oder Snowflake. Wir achten auf die Integration in Ihre bestehende Infrastruktur und berücksichtigen dabei die Anforderungen an
Data Governance und Sicherheit. So entsteht eine skalierbare Umgebung, die flexibel mit Ihren Anforderungen wächst und die technologische Grundlage für datengetriebenes Arbeiten bildet.
Unsere Technologien
Florian Bechler
Chief Technology Officer
lead link
FAQ zu Data Lakehouse
Was ist ein Data Lakehouse?
Ein Data Lakehouse ist eine Datenarchitektur, die die flexible Speicherung großer Mengen strukturierter, semi-strukturierter und unstrukturierter Daten eines Data Lakes mit zentralen Eigenschaften eines Data Warehouses wie Transaktionssicherheit, Governance und hoher Abfrageperformance verbindet.
Was unterscheidet ein Data Lakehouse von einem klassischen Data Warehouse?
Ein Data Lakehouse vereint die kostengünstige, flexible Speicherung eines Data Lake mit der Transaktionssicherheit und den schnellen Abfragen eines klassischen Data Warehouse. Anders als ein Data Warehouse kann es strukturierte, semi-strukturierte und unstrukturierte Daten in einer gemeinsamen Architektur speichern und für unterschiedliche Analyse- und Anwendungsszenarien bereitstellen.
Was unterscheidet ein Data Lakehouse von einem Data Lake?
Ein Data Lake speichert Daten flexibel und skalierbar. Ein Data Lakehouse ergänzt diese Flexibilität um Funktionen für Transaktionssicherheit, Governance und performante Abfragen und macht die Daten damit direkt für BI, Analytics, Data Science und AI nutzbar.
Was ist ein Open Lakehouse?
Ein Open Lakehouse setzt auf offene Standards, Interoperabilität und modulare Architekturprinzipien. Dadurch können Daten und Komponenten über unterschiedliche Technologien hinweg genutzt und Abhängigkeiten von einzelnen Anbietern vermieden werden.
Für welche Anwendungsfälle eignet sich ein Data Lakehouse?
Ein Data Lakehouse eignet sich für unterschiedliche datenbasierte Anwendungsszenarien – von Business Intelligence, Reporting und Analytics über Data Science und Machine Learning bis zu IoT, Echtzeit-Auswertungen und AI. Besonders interessant ist der Ansatz, wenn unterschiedliche Datenarten und wachsende Datenmengen für mehrere Anwendungsfälle gemeinsam genutzt werden sollen.
Auf welchen Plattformen setzt QUNIS Data-Lakehouse-Architekturen um?
Herstellerunabhängig – je nach Rahmenbedingungen z. B. auf Microsoft Fabric, Databricks oder Snowflake.
Arbeitet QUNIS herstellerunabhängig?
Ja. QUNIS berät technologieoffen – von Microsoft und SAP bis Databricks und Snowflake.
Was kostet ein Erstgespräch?
Das erste Beratungsgespräch ist kostenfrei und unverbindlich.
Kommen Sie mit uns ins Gespräch!
Sie wollen dieses Thema vertiefen oder haben Fragen? Sagen Sie uns kurz, was Sie planen und erreichen wollen und wo Sie mit Ihrem Vorhaben gerade stehen.
Wir freuen uns auf den Austausch mit Ihnen!